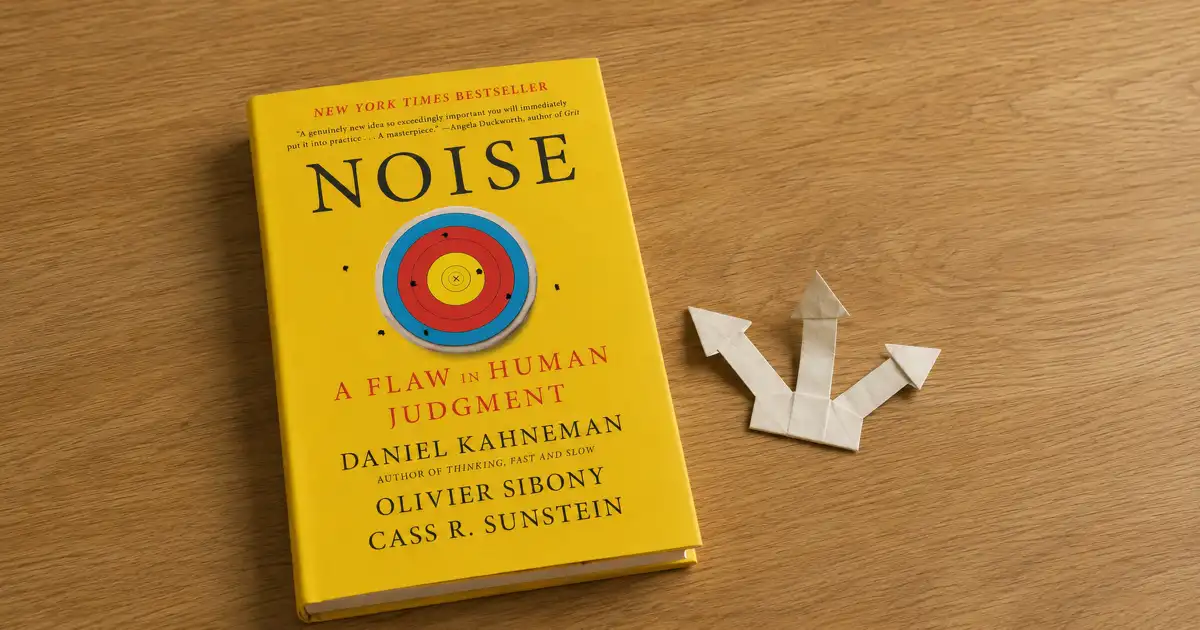
Noise — por qué dos evaluadores ven resultados distintos
Noise aporta una idea incómoda para las decisiones de talento: dos evaluadores competentes pueden aplicar el mismo criterio y llegar a conclusiones distintas por razones que el sistema nunca decidió aceptar.
Daniel Kahneman, Olivier Sibony y Cass Sunstein llaman ruido a la variabilidad indeseada en juicios sobre un mismo problema. El libro, publicado en 2021, desplaza la atención desde el error individual hacia la dispersión del sistema. Esa es su contribución más fértil para evaluar skills. También es la parte que exige mayor cuidado al trasladarla.
El libro mira donde las organizaciones suelen dejar de preguntar
Cuando dos evaluadores discrepan, la conversación suele buscar quién fue indulgente, severo o sesgado. Noise propone observar otra propiedad: cuánto variarían los juicios si casos comparables fueran asignados a personas distintas o evaluados en momentos distintos.
El cambio parece menor. En realidad, modifica la unidad de análisis. Una decisión aislada puede parecer razonable y seguir formando parte de un sistema inestable. Ningún evaluador necesita cometer un error evidente para que la dispersión acumulada produzca consecuencias desiguales.
Los autores distinguen ruido de sesgo.
Ambos aumentan el error, pero requieren diagnósticos distintos. Corregir una tendencia general no resuelve la variabilidad entre evaluadores; reducir dispersión tampoco garantiza que la conclusión promedio sea correcta.
Ese contraste ya había sido presentado por Kahneman, Andrew Rosenfield, Linnea Gandhi y Tom Blaser en su artículo de 2016 sobre el costo de las decisiones inconsistentes. Allí proponen auditorías de ruido mediante casos comparables evaluados de forma independiente. Harvard Business Review, “Noise” (se abre en una nueva pestaña)
La idea funciona solo cuando los juicios son comparables
Esta condición merece más espacio del que suele recibir. Dos valoraciones diferentes no constituyen ruido por el solo hecho de discrepar.
Un líder puede haber observado resultados y alcance. Un par puede conocer la coordinación cotidiana. La propia persona accede a razonamientos que otros no ven. Si responden preguntas distintas o juzgan periodos diferentes, parte de la variación contiene contexto legítimo.
También puede existir ambigüedad en el objeto. “Influencia” puede significar claridad al argumentar, capacidad para construir acuerdos o autoridad para movilizar recursos. Si el sistema entrega una etiqueta amplia y permite que cada evaluador complete el significado, la dispersión no nace únicamente del juicio. Empieza en el diseño.
La aplicación rigurosa del concepto requiere mantener constantes, hasta donde sea razonable, el objeto, la información disponible, el periodo, la escala y la tarea de evaluación. Solo entonces la diferencia residual permite investigar variabilidad injustificada. El libro ayuda a preguntar cuánto cambia un juicio comparable. No autoriza a borrar diferencias informativas entre fuentes que observan manifestaciones distintas.
La auditoría vuelve visible un problema que una decisión aislada oculta
Una de las propuestas más útiles del libro es la auditoría de ruido. La lógica consiste en presentar los mismos casos a varios profesionales, mantener independientes sus juicios iniciales y examinar la dispersión.
En evaluaciones de skills, una adaptación prudente podría trabajar con situaciones simuladas, evidencia equivalente y criterios ya definidos. El objetivo no sería identificar al “mejor evaluador”. Sería comprobar si el sistema produce conclusiones demasiado dependientes de quién recibe el caso.
La auditoría tampoco entrega por sí sola el nivel correcto. Revela variación. Después hay que investigar su composición: severidad general, interpretaciones diferentes de ciertas manifestaciones, uso desigual de la escala, dependencia del momento o información faltante.
El libro resulta convincente al mostrar que las organizaciones suelen subestimar esa dispersión. Su énfasis estadístico obliga a mirar patrones que las explicaciones anecdóticas no capturan. Sin embargo, la medición exige casos comparables, independencia y un número suficiente de juicios. Una diferencia ocasional entre dos personas ofrece una señal, no una estimación estable del ruido del sistema.
La higiene de decisión estructura el juicio antes de reducirlo
Noise reúne varias prácticas bajo la idea de higiene de decisión. Igual que otras medidas preventivas, su valor no depende de conocer cuál error específico ocurrirá. Busca reducir condiciones que vuelven inestable el proceso.
En una evaluación de skills, esa disciplina puede traducirse en acciones concretas: definir manifestaciones antes de observar, separar componentes, utilizar la misma escala, reunir evidencia de forma independiente y posponer la impresión global hasta revisar cada parte. También implica registrar qué información faltó y qué discrecionalidad debe conservarse.
La guía de entrevistas estructuradas de OPM (se abre en una nueva pestaña) ofrece evidencia convergente desde la selección laboral. Preguntas vinculadas con competencias del puesto y reglas comunes para observar y evaluar aumentan el acuerdo entre evaluadores. El dominio es distinto, pero el mecanismo coincide: estructurar reduce variación introducida por el proceso.
Aquí aparece el aporte práctico del libro. Estructurar no exige deshumanizar.
El límite está en confundir consistencia con justicia
Un sistema uniforme puede aplicar con gran consistencia una regla injusta, una expectativa irrelevante o una definición estrecha de desempeño. Reducir ruido mejora la regularidad. No demuestra validez, equidad ni calidad de la decisión.
El propio libro reconoce que cero ruido no siempre es posible ni deseable. Las reglas tienen costos. Pueden perder información particular, reducir flexibilidad o trasladar el error hacia el diseño central. En decisiones sobre personas, esa advertencia es especialmente importante porque el contexto puede cambiar legítimamente la interpretación.
La higiene de decisión necesita entonces dos controles. El primero protege la comparabilidad: casos semejantes no deberían recibir conclusiones arbitrariamente distintas. El segundo protege la particularidad: diferencias relevantes no deberían desaparecer para facilitar el cálculo.
Esa tensión explica por qué Noise funciona mejor como crítica del proceso que como defensa de una automatización total. Su pregunta más productiva no es cuánto juicio humano podemos eliminar.
Una reseña útil deja una incomodidad operativa
El libro es amplio, repetitivo en algunos tramos y más sólido al diagnosticar dispersión que al resolver todos los conflictos entre consistencia y criterio. Aun así, ofrece un vocabulario que cambia la conversación. Sesgo y ruido dejan de ser una sola categoría de “subjetividad”. La independencia del juicio, la estructura y la auditoría adquieren una función verificable.
Aplicado a skills, su enseñanza no consiste en forzar coincidencia entre evaluadores. Consiste en diseñar condiciones comparables, medir la variación que queda e interpretar antes de consolidar. El juicio profesional conserva un lugar. Ya no recibe permiso para operar sin estructura ni examen.
Sigue explorando
Quién puede ver qué: acceso, privacidad y propósito en datos de talento
¿Quién necesita ver un dato de talento, con qué detalle y durante cuánto tiempo? La respuesta nace de la tarea autorizada, no del rango jerárquico.
Cuánto tiempo sigue vigente una evaluación de skills
Aunque una evaluación antigua puede seguir orientando desarrollo, quizá resulte insuficiente para asignar una responsabilidad crítica. La fecha no decide sola su vigencia.
Qué puede inferir una IA sobre una skill y qué no debería inferir
¿Qué puede afirmar una IA sobre una skill a partir de rastros digitales? Entre dato, señal, inferencia y decisión existen saltos que necesitan control.
Cómo diseñar un proceso de revisión o apelación de una evaluación
¿Qué debe ocurrir cuando una persona cuestiona una evaluación? La revisión debe comprobar datos, reglas, interpretación y uso sin convertir el resultado en una negociación.
Cómo conectar skills con resultados sin confundir correlación y causalidad
Una correlación entre skills y resultados sirve para abrir una investigación. Hablar de contribución exige explicar el mecanismo, el tiempo y las alternativas.
Qué significa que una evaluación sea válida para una decisión concreta
¿Qué vuelve válida una evaluación para una decisión concreta? La respuesta conecta el uso previsto con la evidencia necesaria, la interpretación admisible y el límite de cualquier conclusión.